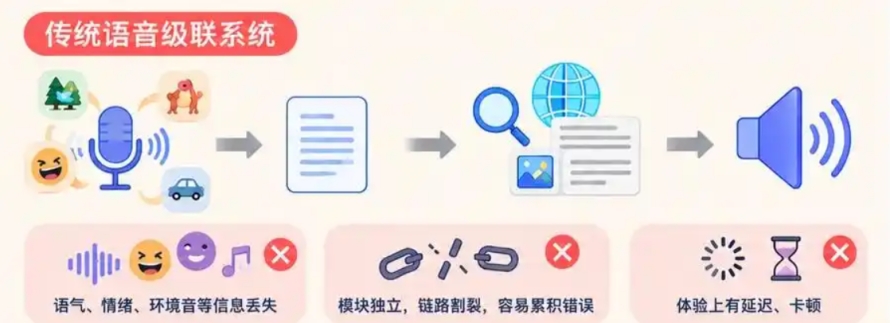
按照以往的经验,大模型音频处理普遍采用语音转文字的级联方案,存在显著技术缺陷。该模式会丢失语音自带的情绪、语气、环境音等关键信息,导致模型场景判断不全面。同时,这种架构将语音转写、声纹识别等功能拆分为多个独立模块串联运行,链路存在断点,不仅容易叠加识别错误,还会造成使用延迟、卡顿等问题,极大影响音频交互体验。
科大讯飞“自主可控”语音大模型上线,Spark-Audio-1.0-Preview能听懂人话
针对传统方案的技术瓶颈,讯飞星火全新国产语音基座大模型 Spark-Audio-1.0-Preview 正式问世。模型打破语音先转文字的固有逻辑,实现音频端到端直接理解,可同步识别人声、环境音、音乐等各类声音信号,精准解读音频中的语义、情绪与场景特征,让人工智能实现了从听清声音到听懂内容的技术升级。
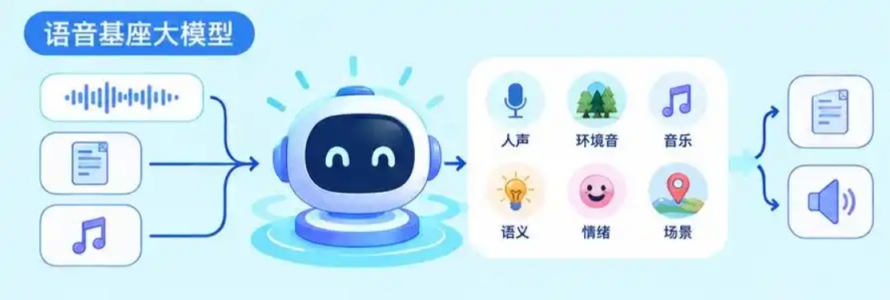
据了解,Spark-Audio-1.0-Preview 为纯国产自研模型,依托国产算力集群训练打造。模型搭配专属音频编码器与混合结构大语言模型,依托千万小时级音频数据训练而成,支持文本、语音双模态输入,覆盖近百种语言、两百余种方言,可一站式完成语音翻译、声纹识别、情感分析、音频问答等多项复杂任务。
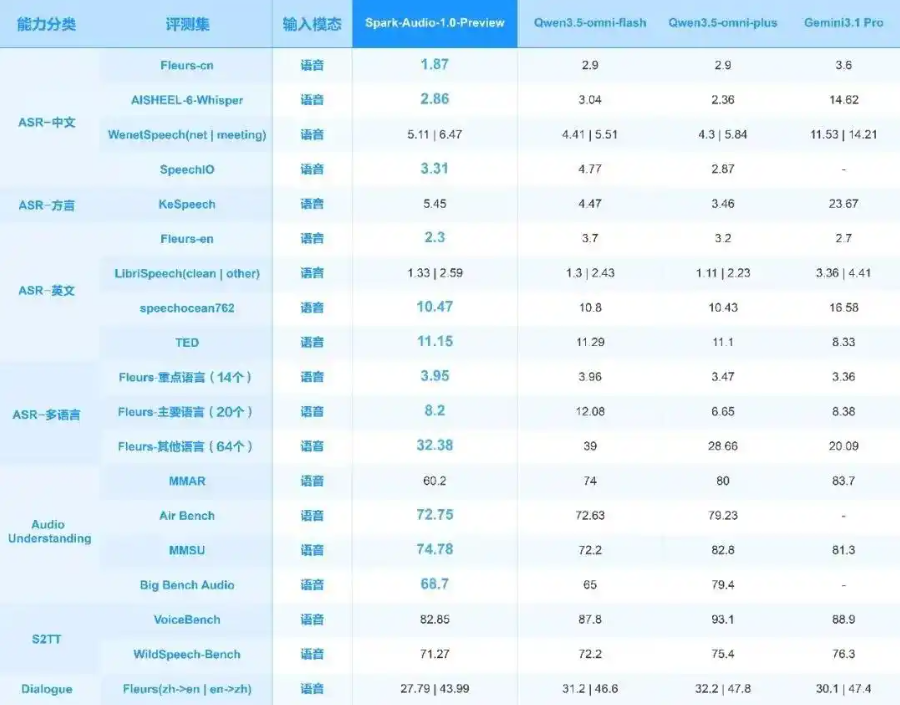
从综合性能来看,该模型表现优异,多项评测指标对标并超越主流海外模型,中文场景拿下最优成绩,在高噪音、小音量等复杂真实场景中优势突出。同时模型通用性稳定无明显缩水,支持行业微调适配各类语音场景。目前 Spark-Audio-1.0-Preview 已开放体验,对应的 API 后续也将逐步登陆讯飞开放平台。
公开测试集-音频
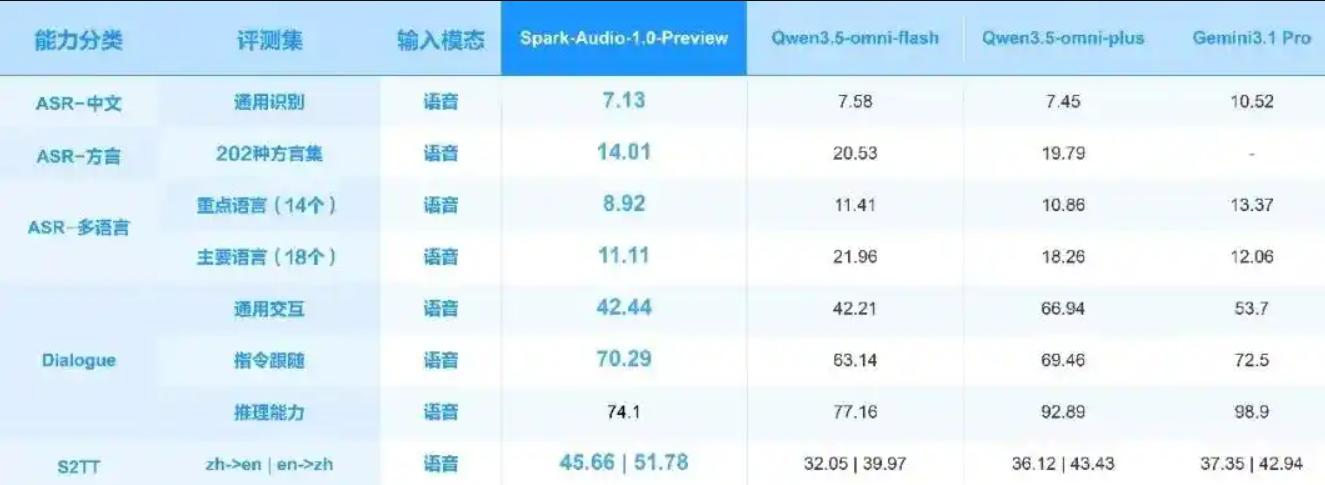
自建测试集-音频
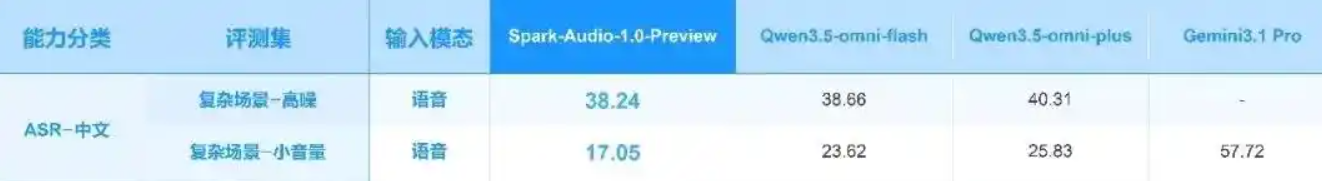
自建测试集-音频-复杂场景
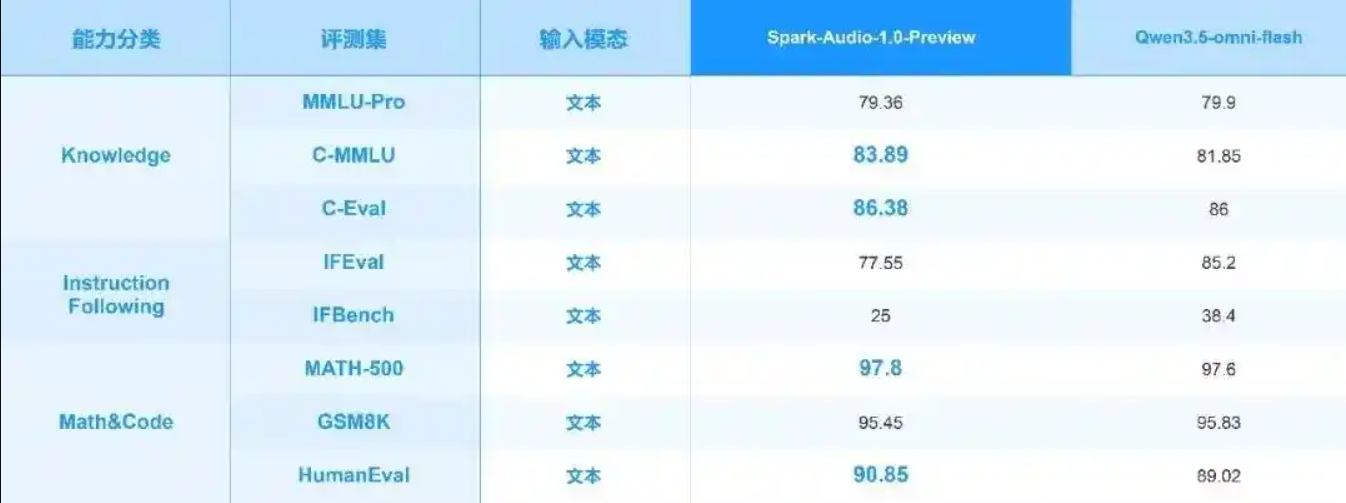
 超级玛丽
 途游五子棋
 植物大战僵尸无尽版
 凹凸世界
 王牌战争
 地牢求生
 第五人格
 问道2手游
 口袋妖怪绿宝石
 超凡先锋
 原神
 热血江湖
 荒岛求生
 香肠派对