11月17日晚,商汤科技发布新模型SenseNova Loop-9B。该模型采用创新的循环架构,通过Loop结构复用模型层参数,并结合流形约束超连接(mHC)技术,在约9B参数规模下显著扩展了计算深度。其设计目标是面向复杂推理、代码、工具调用和多模态任务,探索在有限参数下提升模型能力的新路径。得益于高效架构,其4bit版本权重仅约4.9GB,部署门槛大幅降低。
商汤科技发布SenseNova Loop-9B模型,突破低资源部署瓶颈
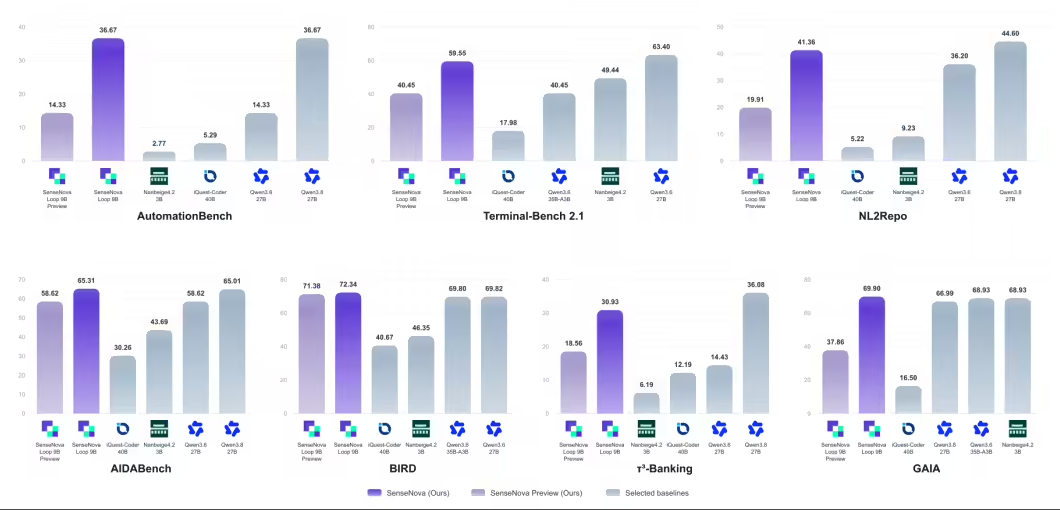
SenseNova Loop-9B的核心原理是循环执行共享的中间层。它将32个物理解码层中的部分中间层组成共享权重的循环模块并循环执行,使模型在一次前向传播中完成56次层计算,推理等效参数约14.6B。同时,模型通过双流mHC技术对循环模块中的两条残差流进行信息路由与融合,并采用混合注意力机制(线性注意力与全注意力相结合)来提升效率。在性能评测上,该模型在Agent与数据分析任务中展现出与更大参数模型相当或更优的竞争力。
该模型在部署友好性方面表现突出。官方4bit量化版本不仅权重轻量,结合8bit KV缓存时,在256K长上下文推理的显存需求也仅约15GB。这使其能够运行在消费级显卡或边缘设备上,大幅降低了本地与私有化部署的门槛。功能上,模型支持文本与图像输入,输出文本,最大上下文长度可达512K tokens,适合处理超长文档、长代码以及复杂的多模态智能体任务。发布当日,商汤还同步开源了模型权重与代码,并提供官方4bit量化版本,方便开发者快速部署。
在模型发布次日,寒武纪官方宣布已完成对SenseNova Loop-9B的Day 0适配,基于vllm_mlu平台打通了其在MLU硬件上的推理链路。适配主要围绕三个方向展开:一是Loop循环层展开,采用静态展开方案将循环计算转换为56个顺序执行的层,以兼容vLLM标准调度和KV缓存机制,同时共享权重存储以控制显存占用;二是MLU算子适配,复用已有的成熟算子实现,快速支持Attention、Linear Attention等核心模块,并复用视觉组件打通多模态推理;三是mHC路由性能优化,通过融合归一化计算和整合Sinkhorn迭代为单个Triton Kernel,降低算子执行和Kernel Launch开销。
SenseNova Loop-9B以架构创新代替参数堆叠,将更高参数级别模型的推理能力带入10GB显存内的硬件平台。发布当天便获寒武纪适配,其他国产厂商也陆续支持,显示了新型模型架构与国产算力生态的快速协同。对开发者而言,可在低成本本地环境部署高性能推理,用于构建Agent工作流、代码助手、长文档分析等应用。此次快速适配也标志着循环计算架构的探索与算力平台的承接正在同步推进。